内卷地狱
LearnAI 知识库Recommender systems

王树森推荐系统学习笔记_重排

Edit Me

王树森推荐系统学习笔记_重排

重排

推荐系统中的多样性

物品相似性的度量

相似性的度量

  • 基于物品属性标签。

    • 类目、品牌、关键词……
  • 基于物品向量表征。

    • 用召回的双塔模型学到的物品向量 (不好)。
    • 基于内容的向量表征 (好)。

基于物品属性标签

  • 物品属性标签:类目、品牌、关键词……
  • 根据 一级类目、二级类目、品牌 计算相似度。
    • 物品 ii:美妆、彩妆、香奈儿。
    • 物品 jj:美妆、香水、香奈儿。
    • 相似度:sim1(i,j)=1\text{sim}_1(i, j) = 1,sim2(i,j)=0\text{sim}_2(i, j) = 0,sim3(i,j)=1\text{sim}_3(i, j) = 1。

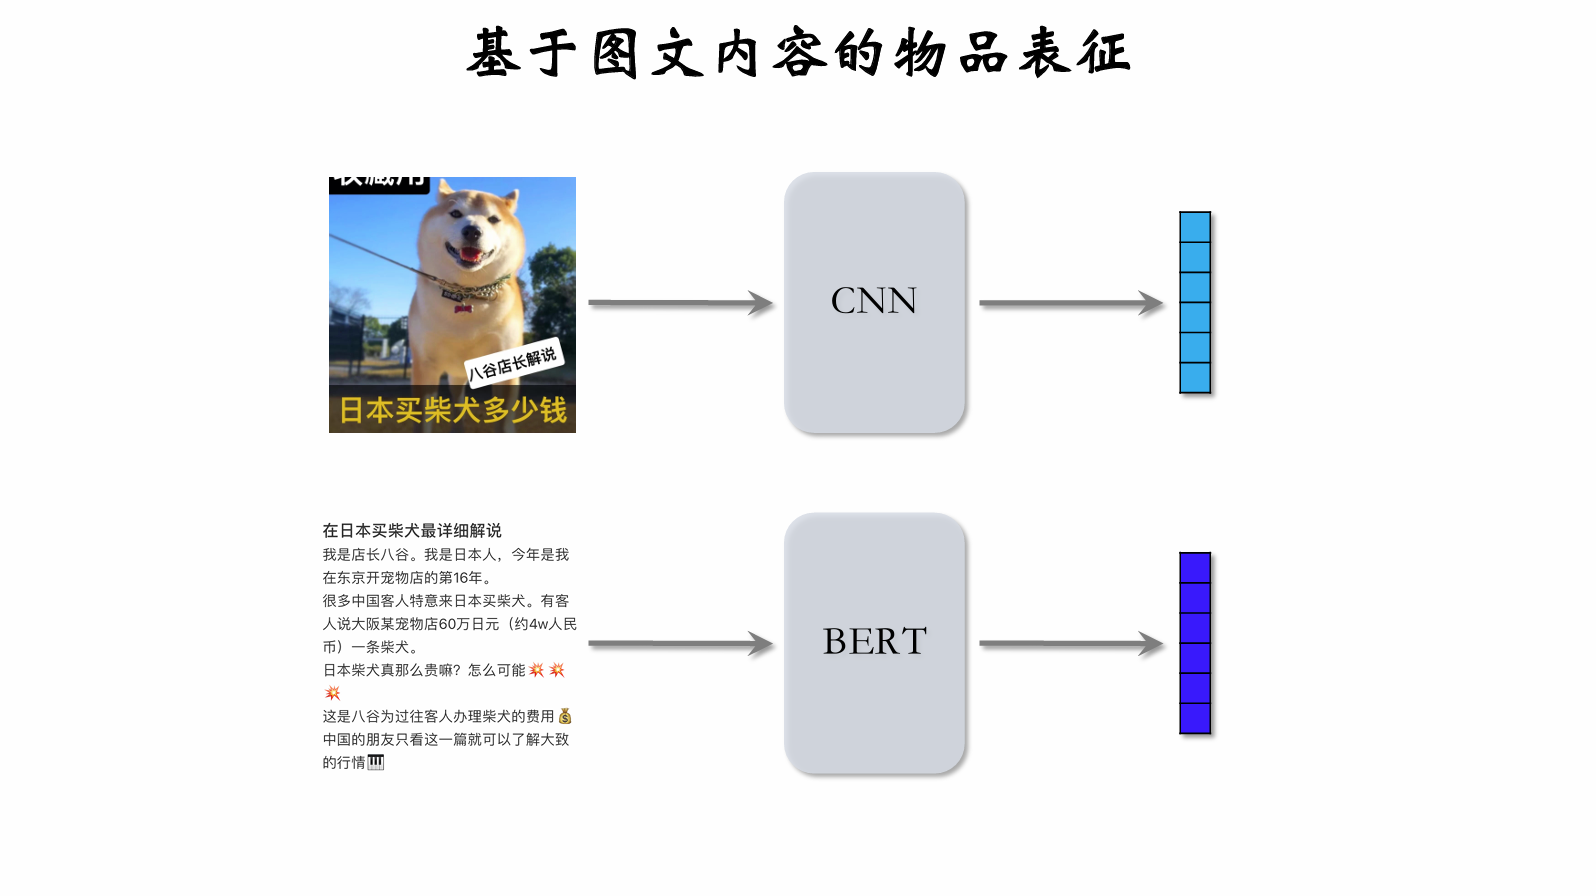
基于图文内容的物品表征可以提升多样性。

可以用 CNN 处理图片输出特征向量,BERT 处理文字输出特征向量。最后将两个向量拼起来即可。

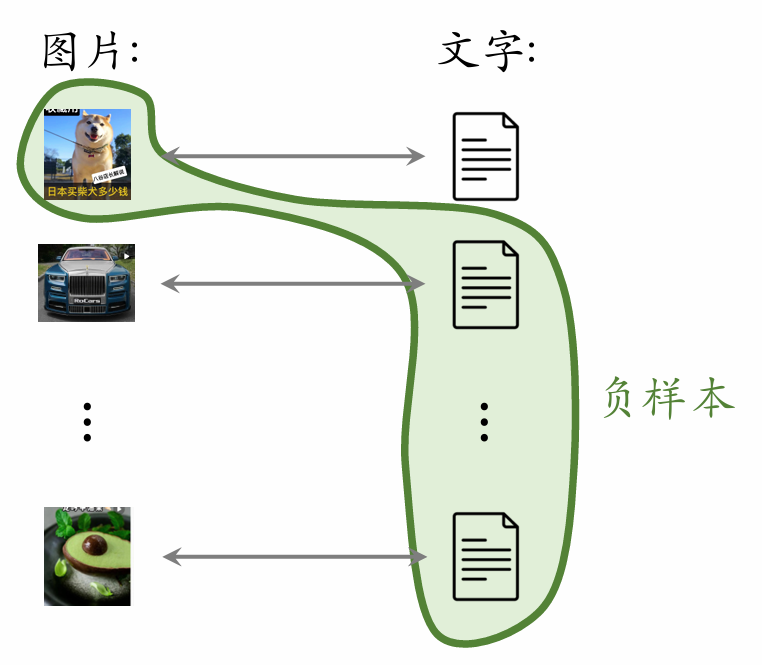
如何训练 CNN 与 BERT?

  • CLIP 是当前公认最有效的预训练方法。
  • 思想:对于 图片—文本 二元组,预测图文是否匹配。
  • 优势:无需人工标注。小红书的笔记天然包含图片 + 文字,大部分笔记图文相关。
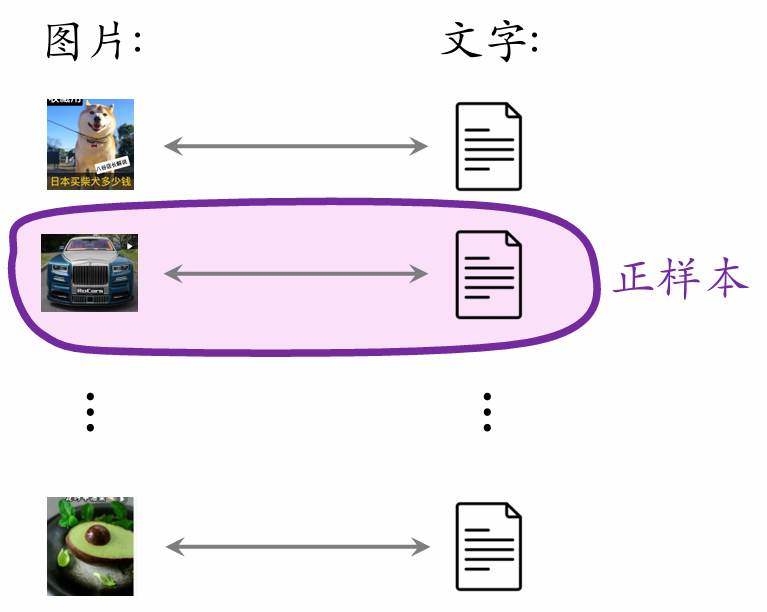
  • 一个 batch 内有 mm 对正样本。
  • 一张图片和 m−1m - 1 条文本组成负样本。
  • 这个 batch 内一共有 m(m−1)m(m - 1) 对负样本。
提升多样性的方法

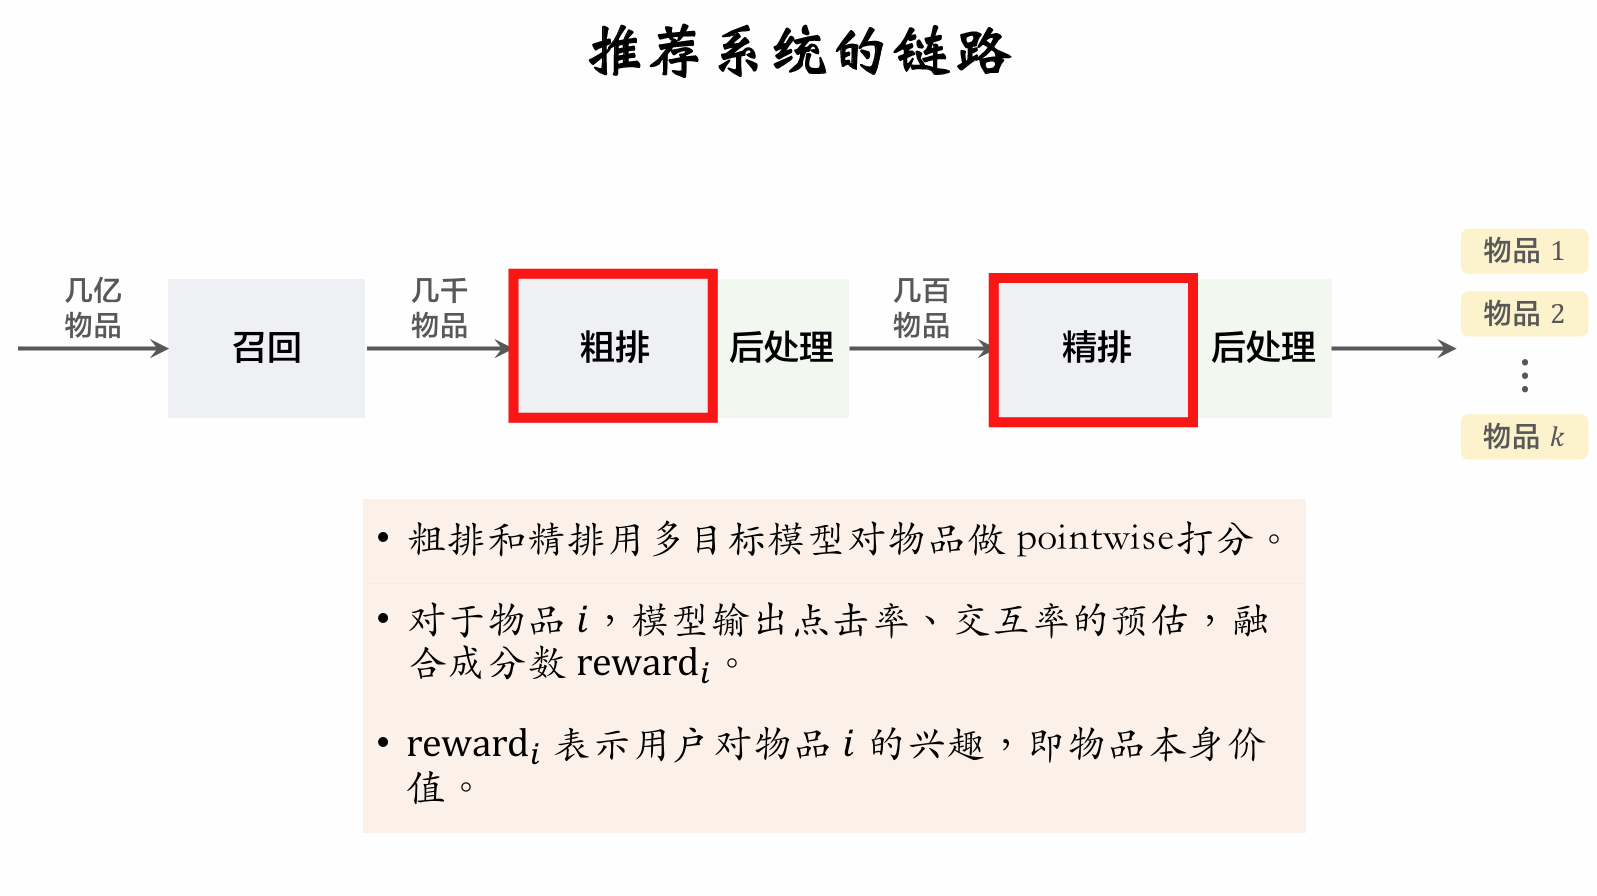
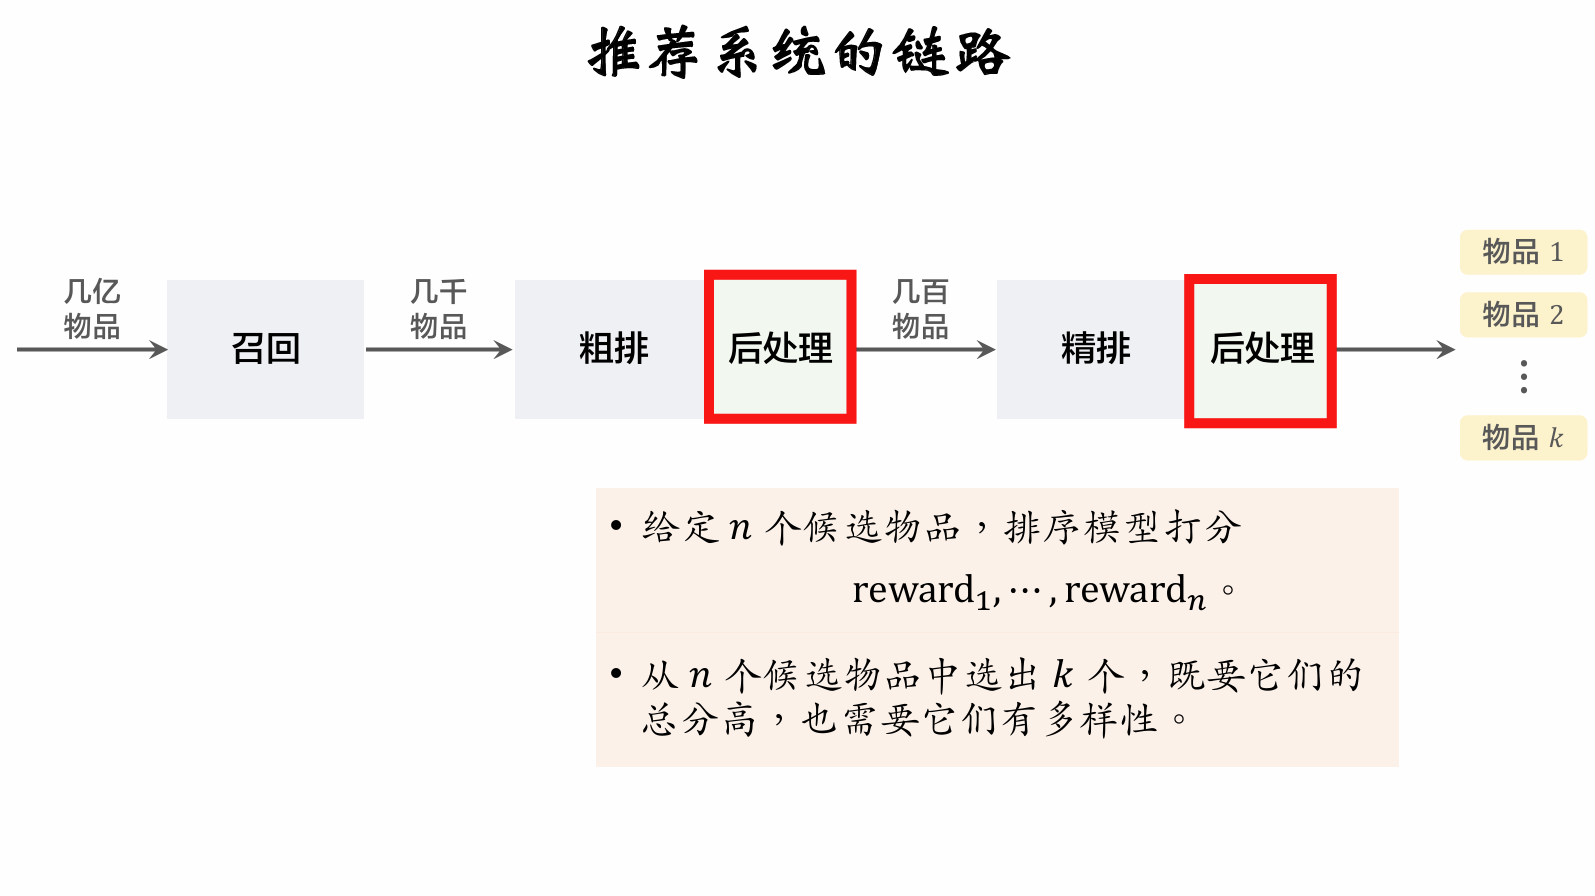
粗排的后处理也需要多样性算法。

精排的后处理也被称为重排。

Maximal Marginal Relevance (MMR)

多样性

  • 精排给 nn 个候选物品打分,融合之后的分数为
    reward1,…,rewardn\text{reward}_1, \dots, \text{reward}_n
  • 把第 ii 和 jj 个物品的相似度记作 sim(i,j)\text{sim}(i,j)。
  • 从 nn 个物品中选出 kk 个,既要有高精排分数,也要有多样性。
MMR多样性算法

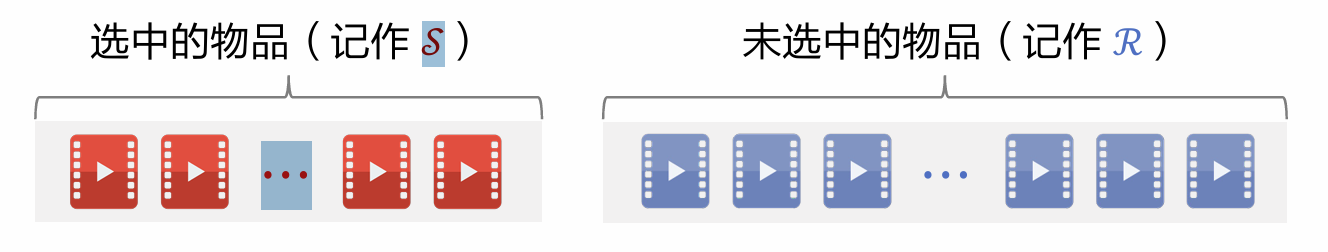
  • 计算集合 R\mathcal{R} 中每个物品 ii 的 Marginal Relevance 分数:

    MRi=θ⋅rewardi−(1−θ)⋅max⁡j∈Ssim(i,j)\text{MR}_i = \theta \cdot \text{reward}_i - (1 - \theta) \cdot \max\limits_{j \in \mathcal{S}} \text{sim}(i, j)
  • rewardi \text{reward}_i 是物品的精排分数,max⁡j∈Ssim(i,j)\max\limits_{j \in \mathcal{S}} \text{sim}(i, j) 是未选中的物品 ii 与已选中物品的相似程度。精排分数分数越高,相似程度越低,物品的 MR 分数就越高。

  • Maximal Marginal Relevance (MMR): 从未选中物品中选出 MR 分数最高的

    arg⁡max⁡i∈RMRi\arg\max\limits_{i \in \mathcal{R}} \text{MR}_i

MMR 多样性算法

  1. 已选中的物品 S\mathcal{S} 初始化为空集,未选中的物品 R\mathcal{R} 初始化为全集 {1,…,n}\{1, \dots, n\}。
  2. 选择精排分数 rewardi\text{reward}_i 最高的物品,从集合 R\mathcal{R} 移到 S\mathcal{S}。
  3. 做 k−1k - 1 轮循环: a. 计算集合 R\mathcal{R} 中所有物品的分数 {MRi}i∈R\{\text{MR}_i\}_{i \in \mathcal{R}}。 b. 选出分数最高的物品,将其从 R\mathcal{R} 移到 S\mathcal{S}。
滑动窗口
  • MMR:

    arg⁡max⁡i∈R{θ⋅rewardi−(1−θ)⋅max⁡j∈Ssim(i,j)}\arg\max\limits_{i \in \mathcal{R}} \left\{ \theta \cdot \text{reward}_i - (1 - \theta) \cdot \max\limits_{j \in \mathcal{S}} \text{sim}(i, j) \right\}
  • 已选中的物品越多(即集合 S\mathcal{S} 越大),越难找出物品 i∈Ri \in \mathcal{R},使得 ii 与 S\mathcal{S} 中的物品都不相似。

  • 设 sim\text{sim} 的取值范围是 [0,1][0,1]。当 S\mathcal{S} 很大时,多样性分数 max⁡j∈Ssim(i,j)\max\limits_{j \in \mathcal{S}} \text{sim}(i, j) 总是约等于 1,导致 MMR 算法失效。

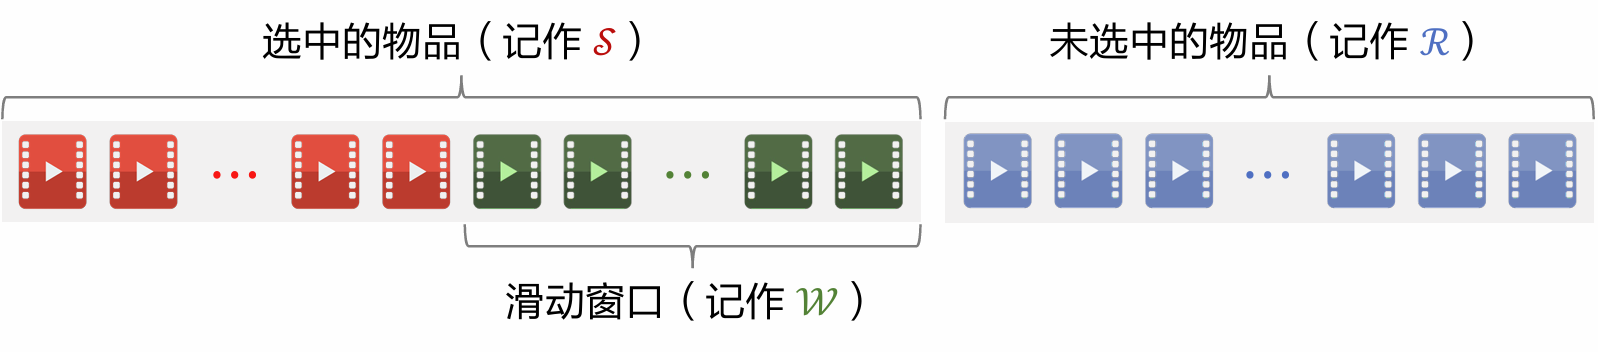
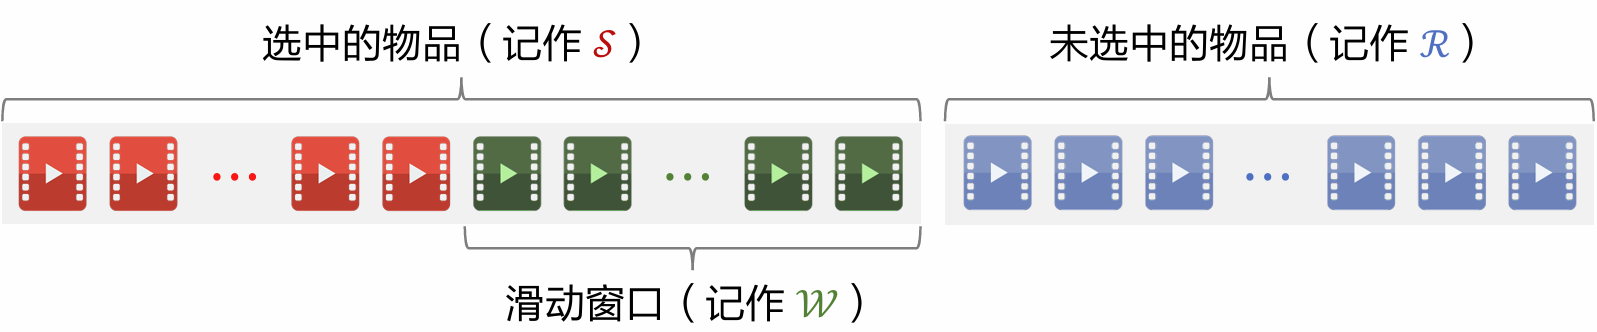
  • 解决方案:设置一个滑动窗口 W\mathcal{W},比如最近选中的 10 个物品,用 W\mathcal{W} 代替 MMR 公式中的 S\mathcal{S}。

  • 标准 MMR:

    arg⁡max⁡i∈R{θ⋅rewardi−(1−θ)⋅max⁡j∈Ssim(i,j)}.\arg\max\limits_{i \in \mathcal{R}} \left\{ \theta \cdot \text{reward}_i - (1 - \theta) \cdot \max\limits_{j \in \mathcal{S}} \text{sim}(i, j) \right\}.
  • 用滑动窗口:

    arg⁡max⁡i∈R{θ⋅rewardi−(1−θ)⋅max⁡j∈Wsim(i,j)}\arg\max\limits_{i \in \mathcal{R}} \left\{ \theta \cdot \text{reward}_i - (1 - \theta) \cdot \max\limits_{j \in \mathcal{W}} \text{sim}(i, j) \right\}

重排的规则

重排的规则

规则:最多连续出现 kk 篇某种笔记

  • 小红书推荐系统的物品分为图文笔记、视频笔记。
  • 最多连续出现 k=5k = 5 篇图文笔记,最多连续出现 k=5k = 5 篇视频笔记。
  • 如果排 ii 到 i+4i+4 的全部是图文笔记,那么排在 i+5i+5 的必须是视频笔记。

规则:每 kk 篇笔记最多出现 1 篇某种笔记

  • 运营推广笔记的精排分会乘以大于 1 的系数(boost),帮助笔记获得更多曝光。
  • 为了防止 boost 影响体验,限制每 k=9k = 9 篇笔记最多出现 1 篇运营推广笔记。
  • 如果排第 ii 位的是运营推广笔记,那么排 i+1i+1 到 i+8i+8 的不能是运营推广笔记。

规则:前 tt 篇笔记最多出现 kk 篇某种笔记

  • 排名前 tt 篇笔记最容易被看到,对用户体验最重要。
    (小红书的 top 4 为首屏)
  • 小红书推荐系统有带电商卡片的笔记,过多可能会影响体验。
  • 前 t=1t=1 篇笔记最多出现 k=0k=0 篇带电商卡片的笔记。
  • 前 t=4t=4 篇笔记最多出现 k=1k=1 篇带电商卡片的笔记。
MMR + 重排规则
  • MMR 每一轮选出一个物品:

    arg⁡max⁡i∈R{θ⋅rewardi−(1−θ)⋅max⁡j∈Wsim(i,j)}\arg\max\limits_{i \in \mathcal{R}} \left\{ \theta \cdot \text{reward}_i - (1 - \theta) \cdot \max\limits_{j \in \mathcal{W}} \text{sim}(i, j) \right\}
  • 重排结合 MMR 与规则,在满足规则的前提下最大化 MR。

  • 每一轮先用规则排除掉 R\mathcal{R} 中的部分物品,得到子集 R′\mathcal{R'}。

  • MMR 公式中的 R\mathcal{R} 替换成子集 R′\mathcal{R'},选中的物品符合规则。

DPP:数学基础

超平行体

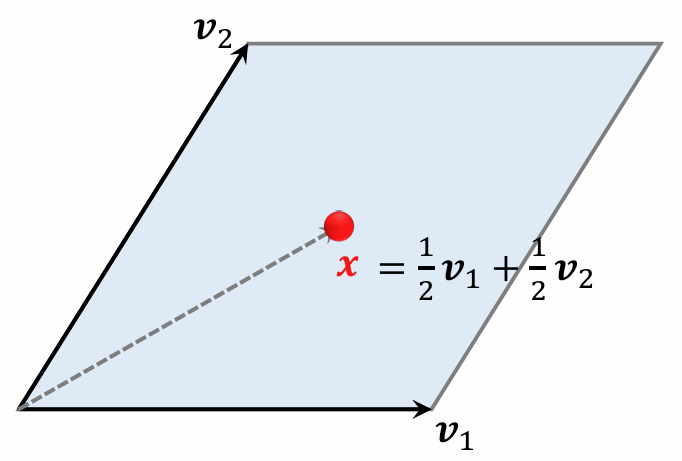
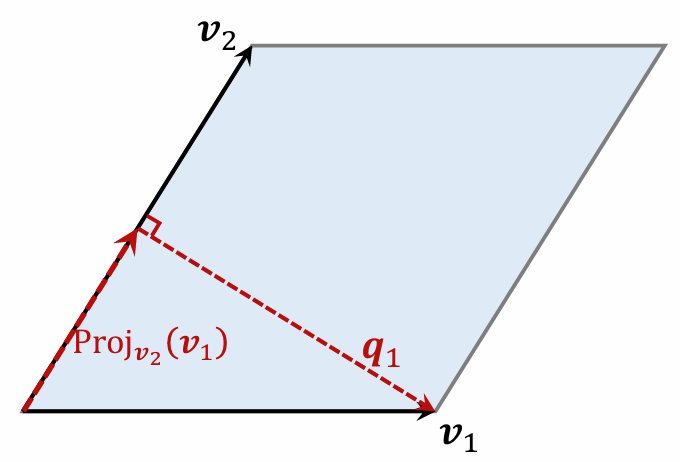
  • 2 维空间的 超平行体 为 平行四边形。

  • 平行四边形中的点可以表示为:

    x=α1v1+α2v2.\mathbf{x} = \alpha_1 \mathbf{v}_1 + \alpha_2 \mathbf{v}_2.

  • 系数 α1\alpha_1 和 α2\alpha_2 取值范围是 [0,1][0,1]。

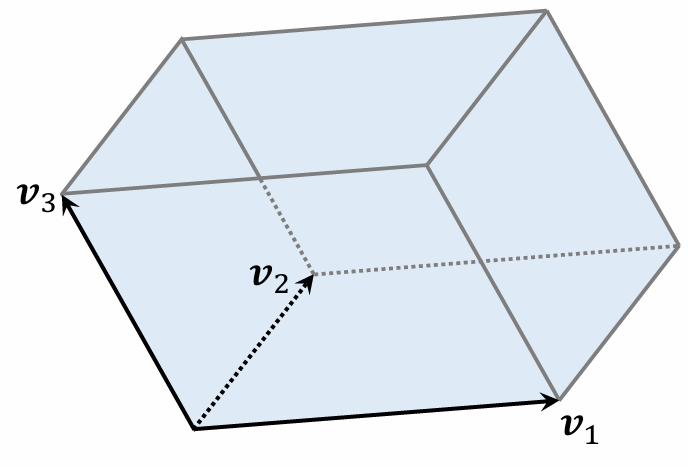
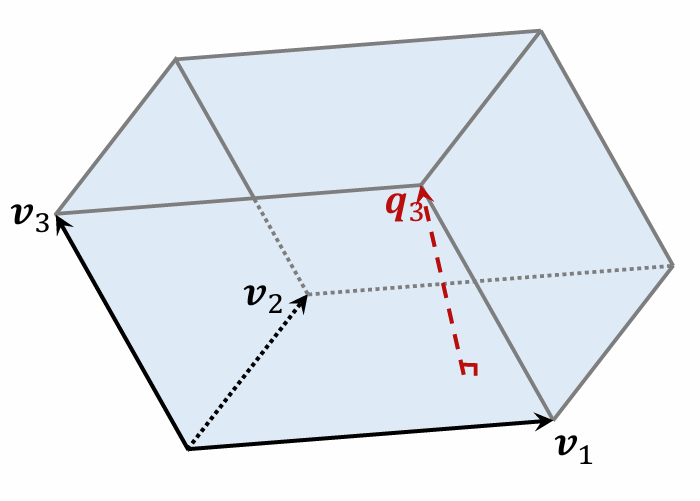
  • 3 维空间的 超平行体 为 平行六面体。

  • 平行六面体中的点可以表示为:

    x=α1v1+α2v2+α3v3.\mathbf{x} = \alpha_1 \mathbf{v}_1 + \alpha_2 \mathbf{v}_2 + \alpha_3 \mathbf{v}_3.

  • 系数 α1,α2,α3\alpha_1, \alpha_2, \alpha_3 取值范围是 [0,1][0,1]。

超平行体

  • 一组向量 v1,⋯ ,vk∈Rd\mathbf{v}_1, \cdots, \mathbf{v}_k \in \mathbb{R}^d 可以确定一个 kk 维超平行体:

    P(v1,⋯ ,vk)={α1v1+⋯+αkvk∣0≤α1,⋯ ,αk≤1}.P(\mathbf{v}_1, \cdots, \mathbf{v}_k) = \{\alpha_1 \mathbf{v}_1 + \cdots + \alpha_k \mathbf{v}_k \mid 0 \leq \alpha_1, \cdots, \alpha_k \leq 1\}.

  • 要求 k≤dk \leq d,比如 d=3d = 3 维空间中有 k=2k = 2 维平行四边形。

  • 如果 v1,⋯ ,vk\mathbf{v}_1, \cdots, \mathbf{v}_k 线性相关,则体积 vol(P)=0\text{vol}(P) = 0。(例:有 k=3k = 3 个向量,落在一个平面上,则平行六面体的体积为 0。)

平行四边形的面积

以 v2\mathbf{v}_2 为底,如何计算高 q1\mathbf{q}_1?

  • 计算 v1\mathbf{v}_1 在 v2\mathbf{v}_2 上的投影:

    Projv2(v1)=v1Tv2∥v2∥22⋅v2.\text{Proj}_{\mathbf{v}_2}(\mathbf{v}_1) = \frac{\mathbf{v}_1^T \mathbf{v}_2}{\|\mathbf{v}_2\|_2^2} \cdot \mathbf{v}_2.

  • 计算

    q1=v1−Projv2(v1).\mathbf{q}_1 = \mathbf{v}_1 - \text{Proj}_{\mathbf{v}_2}(\mathbf{v}_1).

  • 性质:底 v2\mathbf{v}_2 与高 q1\mathbf{q}_1 正交。

平行六面体的体积

  • 体积 = 底面积 × ∥高∥2\|\text{高}\|_2。

  • 平行四边形 P(v1,v2)P(\mathbf{v}_1, \mathbf{v}_2) 是平行六面体 P(v1,v2,v3)P(\mathbf{v}_1, \mathbf{v}_2, \mathbf{v}_3) 的底。

  • 高 q3\mathbf{q}_3 垂直于底 P(v1,v2)P(\mathbf{v}_1, \mathbf{v}_2)。

体积何时最大化、最小化?

  • 设 v1\mathbf{v}_1、v2\mathbf{v}_2、v3\mathbf{v}_3 都是单位向量。

  • 当三个向量正交时,平行六面体为正方体,体积最大化,vol=1\text{vol} = 1。

  • 当三个向量线性相关时,体积最小化,vol=0\text{vol} = 0。

衡量物品多样性
  • 给定 kk 个物品,把它们表征为单位向量 v1,⋯ ,vk∈Rd\mathbf{v}_1, \cdots, \mathbf{v}_k \in \mathbb{R}^d。(d≥kd \geq k)

  • 用超平行体的体积衡量物品的多样性,体积介于 00 和 11 之间。

  • 如果 v1,⋯ ,vk\mathbf{v}_1, \cdots, \mathbf{v}_k 两两正交(多样性好),则体积最大化,vol=1\text{vol} = 1。

  • 如果 v1,⋯ ,vk\mathbf{v}_1, \cdots, \mathbf{v}_k 线性相关(多样性差),则体积最小化,vol=0\text{vol} = 0。

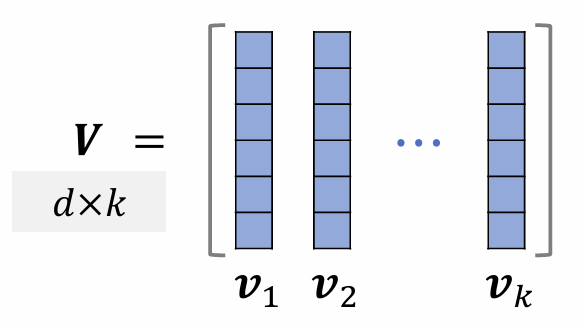
  • 给定 kk 个物品,把它们表征为单位向量 v1,⋯ ,vk∈Rd\mathbf{v}_1, \cdots, \mathbf{v}_k \in \mathbb{R}^d。(d≥kd \geq k)

  • 把它们作为矩阵 V∈Rd×k\mathbf{V} \in \mathbb{R}^{d \times k} 的列。

  • 设 d≥kd \geq k,行列式与体积满足:

    det⁡(VTV)=vol(P(v1,⋯ ,vk))2.\det(\mathbf{V}^T \mathbf{V}) = \text{vol}(P(\mathbf{v}_1, \cdots, \mathbf{v}_k))^2.

  • 因此,可以用行列式 det⁡(VTV)\det(\mathbf{V}^T \mathbf{V}) 衡量向量 v1,⋯ ,vk\mathbf{v}_1, \cdots, \mathbf{v}_k 的多样性。

DPP:多样性算法

多样性问题
  • 精排给 nn 个物品打分:reward1,⋯ ,rewardn\text{reward}_1, \cdots, \text{reward}_n。

  • nn 个物品的向量表征:v1,⋯ ,vn∈Rd\mathbf{v}_1, \cdots, \mathbf{v}_n \in \mathbb{R}^d。

  • 从 nn 个物品中选出 kk 个物品,组成集合 S\mathcal{S}。

    • 价值大:分数之和 ∑j∈Srewardj\sum_{j \in \mathcal{S}} \text{reward}_j 越大越好。
    • 多样性好:S\mathcal{S} 中 kk 个向量组成的超平行体 P(S)P(\mathcal{S}) 的体积越大越好。
  • 集合 S\mathcal{S} 中的 kk 个物品的向量作为列,组成矩阵 VS∈Rd×k\mathbf{V}_{\mathcal{S}} \in \mathbb{R}^{d \times k}。

  • 以这 kk 个向量作为边,组成超平行体 P(S)P(\mathcal{S})。

  • 体积 vol(P(S))\text{vol}(P(\mathcal{S})) 可以衡量 S\mathcal{S} 中物品的多样性。

  • 设 k≤dk \leq d,行列式与体积满足:

    det⁡(VSTVS)=vol(P(S))2\det(\mathbf{V}_{\mathcal{S}}^T \mathbf{V}_{\mathcal{S}}) = \text{vol}(P(\mathcal{S}))^2

行列式点过程(DPP)
  • DPP 是一种传统的统计机器学习方法:

    arg⁡max⁡S:∣S∣=klog⁡det⁡(VSTVS)\arg\max_{\mathcal{S}: |\mathcal{S}|=k} \log \det(\mathbf{V}_{\mathcal{S}}^T \mathbf{V}_{\mathcal{S}})
  • Hulu 的论文将 DPP 应用在推荐系统:

    arg⁡max⁡S:∣S∣=kθ⋅(∑j∈Srewardj)+(1−θ)⋅log⁡det⁡(VSTVS)\arg\max_{\mathcal{S}: |\mathcal{S}|=k} \theta \cdot \left( \sum_{j \in \mathcal{S}} \text{reward}_j \right) + (1 - \theta) \cdot \log \det(\mathbf{V}_{\mathcal{S}}^T \mathbf{V}_{\mathcal{S}})
  • DPP 应用在推荐系统:

    arg⁡max⁡S:∣S∣=kθ⋅(∑j∈Srewardj)+(1−θ)⋅log⁡det⁡(VSTVS)\arg\max_{\mathcal{S}: |\mathcal{S}|=k} \theta \cdot \left( \sum_{j \in \mathcal{S}} \text{reward}_j \right) + (1 - \theta) \cdot \log \det(\mathbf{V}_{\mathcal{S}}^T \mathbf{V}_{\mathcal{S}})
  • 设 A\mathbf{A} 为 n×nn \times n 的矩阵,它的 (i,j)(i,j) 元素为 aij=viTvja_{ij} = \mathbf{v}_i^T \mathbf{v}_j。

  • 给定向量 v1,⋯ ,vn∈Rd\mathbf{v}_1, \cdots, \mathbf{v}_n \in \mathbb{R}^d,需要 O(n2d)O(n^2 d) 时间计算 A\mathbf{A}。

  • AS=VSTVS\mathbf{A}_{\mathcal{S}} = \mathbf{V}_{\mathcal{S}}^T \mathbf{V}_{\mathcal{S}} 为 A\mathbf{A} 的一个 k×kk \times k 子矩阵。如果 i,j∈Si, j \in \mathcal{S},则 aija_{ij} 是 AS\mathbf{A}_{\mathcal{S}} 的一个元素。

  • DPP 应用在推荐系统:

    arg⁡max⁡S:∣S∣=kθ⋅(∑j∈Srewardj)+(1−θ)⋅log⁡det⁡(AS)\arg\max_{\mathcal{S}: |\mathcal{S}|=k} \theta \cdot \left( \sum_{j \in \mathcal{S}} \text{reward}_j \right) + (1 - \theta) \cdot \log \det(\mathbf{A}_{\mathcal{S}})
  • DPP 是个组合优化问题,从集合 {1,⋯ ,n}\{1, \cdots, n\} 中选出一个大小为 kk 的子集 S\mathcal{S}。

  • 用 S\mathcal{S} 表示已选中的物品,用 R\mathcal{R} 表示未选中的物品,贪心算法求解:

    arg⁡max⁡i∈Rθ⋅rewardi+(1−θ)⋅log⁡det⁡(AS∪{i})\arg\max_{i \in \mathcal{R}} \theta \cdot \text{reward}_i + (1 - \theta) \cdot \log \det(\mathbf{A}_{\mathcal{S} \cup \{i\}})
求解DPP

暴力算法

  • 贪心算法求解:

    arg⁡max⁡i∈Rθ⋅rewardi+(1−θ)⋅log⁡det⁡(AS∪{i}).\arg\max_{i \in \mathcal{R}} \theta \cdot \text{reward}_i + (1 - \theta) \cdot \log \det(\mathbf{A}_{\mathcal{S} \cup \{i\}}).
  • 计算复杂度分析:

    • 对于单个 ii,计算 AS∪{i}\mathbf{A}_{\mathcal{S} \cup \{i\}} 的行列式需要 O(∣S∣3)O(|\mathcal{S}|^3) 时间。

    • 对于所有的 i∈Ri \in \mathcal{R},计算行列式需要时间 O(∣S∣3⋅∣R∣)O(|\mathcal{S}|^3 \cdot |\mathcal{R}|)。

    • 需要求解上述式子 kk 次才能选出 kk 个物品。如果暴力计算行列式,那么总时间复杂度为:

      O(∣S∣3⋅∣R∣⋅k)=O(nk4).O(|\mathcal{S}|^3 \cdot |\mathcal{R}| \cdot k) = O(nk^4).
  • 暴力算法的总时间复杂度为:

    O(n2d+nk4).O(n^2 d + nk^4).

Hulu 的快速算法

  • Hulu 的论文设计了一种数值算法,仅需 O(n2d+nk2)O(n^2 d + nk^2) 的时间从 nn 个物品中选出 kk 个物品。

  • 给定向量 v1,⋯ ,vn∈Rd\mathbf{v}_1, \cdots, \mathbf{v}_n \in \mathbb{R}^d,需要 O(n2d)O(n^2 d) 时间计算 A\mathbf{A}。

  • 用 O(nk2)O(nk^2) 时间计算所有的行列式(利用 Cholesky 分解)。

  • Cholesky 分解 AS=LLT\mathbf{A}_{\mathcal{S}} = \mathbf{L} \mathbf{L}^T,其中 L\mathbf{L} 是下三角矩阵(对角线以上的元素全零)。

  • Cholesky 分解可供计算 AS\mathbf{A}_{\mathcal{S}} 的行列式:

    • 下三角矩阵 L\mathbf{L} 的行列式 det⁡(L)\det(\mathbf{L}) 等于 L\mathbf{L} 对角线元素乘积。

    • AS\mathbf{A}_{\mathcal{S}} 的行列式为:

      det⁡(AS)=det⁡(L)2=∏ilii2.\det(\mathbf{A}_{\mathcal{S}}) = \det(\mathbf{L})^2 = \prod_i l_{ii}^2.
  • 已知 AS=LLT\mathbf{A}_{\mathcal{S}} = \mathbf{L} \mathbf{L}^T,则可以快速求出所有 AS∪{i}\mathbf{A}_{\mathcal{S} \cup \{i\}} 的 Cholesky 分解,因此可以快速计算出所有 AS∪{i}\mathbf{A}_{\mathcal{S} \cup \{i\}} 的行列式。

  • 贪心算法求解:

    arg⁡max⁡i∈Rθ⋅rewardi+(1−θ)⋅log⁡det⁡(AS∪{i}).\arg\max_{i \in \mathcal{R}} \theta \cdot \text{reward}_i + (1 - \theta) \cdot \log \det(\mathbf{A}_{\mathcal{S} \cup \{i\}}).
  • 初始化:S\mathcal{S} 中只有一个物品,AS\mathbf{A}_{\mathcal{S}} 是 1×11 \times 1 的矩阵。

  • 每一轮循环:

    • 基于上一轮算出的 AS=LLT\mathbf{A}_{\mathcal{S}} = \mathbf{L} \mathbf{L}^T,快速求出 AS∪{i}\mathbf{A}_{\mathcal{S} \cup \{i\}} 的 Cholesky 分解(∀i∈R\forall i \in \mathcal{R})。
    • 从而求出 log⁡det⁡(AS∪{i})\log \det(\mathbf{A}_{\mathcal{S} \cup \{i\}})。
DPP 的扩展

滑动窗口

  • 用 S\mathbf{S} 表示已选中的物品,用 R\mathcal{R} 表示未选中的物品,DPP 的贪心算法求解:

    arg⁡max⁡i∈Rθ⋅rewardi+(1−θ)⋅log⁡det⁡(AS∪{i}).\arg\max\limits_{i \in \mathcal{R}} \theta \cdot \text{reward}_i + (1 - \theta) \cdot \log \det (\mathbf{A}_{\mathbf{S} \cup \{i\}}).
  • 随着集合 S\mathbf{S} 增大,其中相似物品越来越多,物品向量会趋近线性相关。

  • 行列式 det⁡(AS)\det(\mathbf{A}_{\mathbf{S}}) 会塌缩到零,对数趋于负无穷。

  • 贪心算法:

    arg⁡max⁡i∈Rθ⋅rewardi+(1−θ)⋅log⁡det⁡(AS∪{i})\arg\max\limits_{i \in \mathcal{R}} \theta \cdot \text{reward}_i + (1 - \theta) \cdot \log \det (\mathbf{A}_{\mathbf{S} \cup \{i\}})
  • 用滑动窗口:

    arg⁡max⁡i∈Rθ⋅rewardi+(1−θ)⋅log⁡det⁡(AW∪{i})\arg\max\limits_{i \in \mathcal{R}} \theta \cdot \text{reward}_i + (1 - \theta) \cdot \log \det (\mathbf{A}_{\mathcal{W} \cup \{i\}})

规则约束

  • 贪心算法每轮从 R\mathcal{R} 中选出一个物品:

    arg⁡max⁡i∈Rθ⋅rewardi+(1−θ)⋅log⁡det⁡(AW∪{i})\arg\max\limits_{i \in \mathcal{R}} \theta \cdot \text{reward}_i + (1 - \theta) \cdot \log \det (\mathbf{A}_{\mathcal{W} \cup \{i\}})
  • 有很多规则约束,例如最多连续出 5 篇视频笔记(如果已经连续出了 5 篇视频笔记,下一篇必须是图文笔记)。

  • 用规则排除掉 R\mathcal{R} 中的部分物品,得到子集 R′\mathcal{R'},然后求解:

    arg⁡max⁡i∈R′θ⋅rewardi+(1−θ)⋅log⁡det⁡(AW∪{i})\arg\max\limits_{i \in \mathcal{R'}} \theta \cdot \text{reward}_i + (1 - \theta) \cdot \log \det (\mathbf{A}_{\mathcal{W} \cup \{i\}})

贡献者


这篇文章有帮助吗?

最近更新

Involution Hell© 2026 byCommunityunderCC BY-NC-SA 4.0CCBYNCSA